AIクローラーとは?主要ボット一覧と、拒否すべきかの判断|robots.txtの書き方【2026年】
AIクローラーとは、ChatGPTやClaude、Geminiなどを提供する企業が、AIの学習や、AIの検索・回答の材料にするためにウェブページを集めるボット(自動で巡回するプログラム)のことです。GPTBot、ClaudeBot、Google-Extended、Amazonbotといった名前を、サーバーのログやニュースで見かけた方も多いと思います。
「AIに勝手に学習されたくない」「でも、AIの回答には自分のサイトを紹介してほしい」——このふたつは、設定しだいで両立できます。ただし、止め方を間違えると、AIの回答に出てこなくなります。この記事では、主要なAIクローラーの用途を各社の公式情報で一覧にし、拒否すべきかどうかの判断と、robots.txtの書き方、効かないケースまでを、2026年11月時点の情報でまとめました。
書き手は、集客特化のAIエージェント「ミセルAI」を開発している宮川です。AI検索への対策(AEO/LLMO)を自動化する立場から、当サイト自身の設定もあわせて紹介します。
この記事の結論
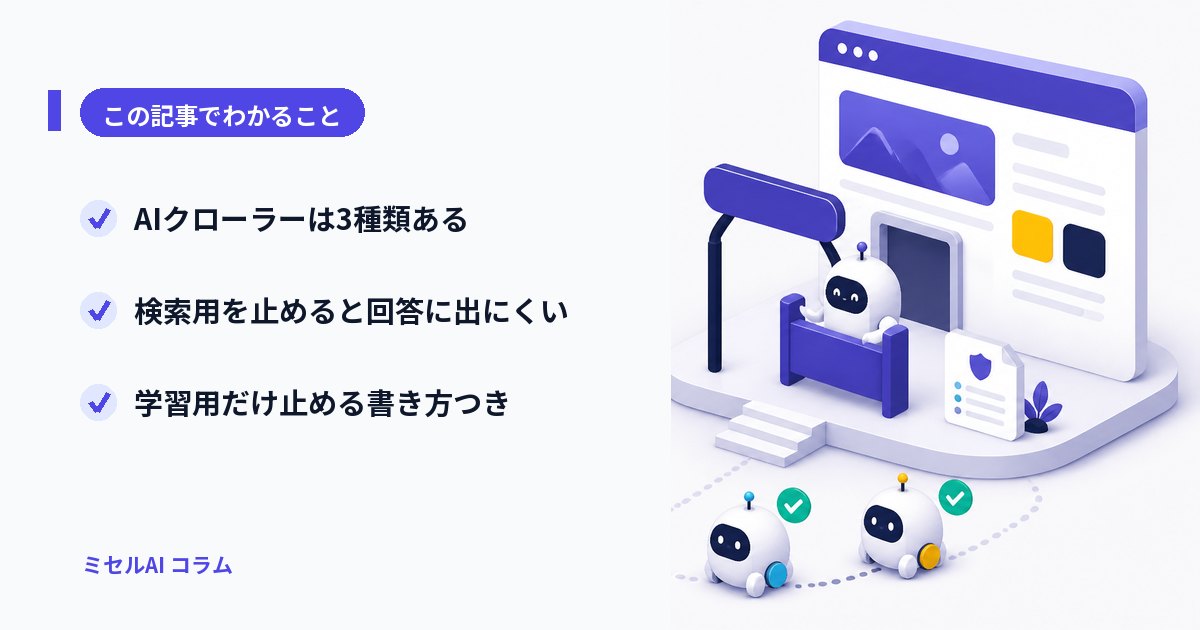
- AIクローラーには、学習用・検索/回答用・ユーザー操作用の3種類がある。各社はボットを用途ごとに分けている
- 検索・回答用を止めると、そのAIの回答に出にくくなる。AIに紹介されたいなら、止めるのは学習用だけにする
- 学習用を止めても、検索での表示には基本的に影響しない。ただしGoogle-Extendedは、Geminiアプリでの回答の根拠づけも止めてしまう点に注意
- robots.txtは「お願い」で、強制力はない。ユーザーの操作で訪れるボットには効かない場合があり、確実に守りたいものはログインが必要な領域に置く
- 文化庁は、robots.txtでAI学習用クローラーを止めることはサイト管理者が自由に行えると整理している。ただし、反対の意思を示すだけで法的に学習を禁止できるわけではない
筆者: 宮川椋(合同会社LeapRe代表)。集客特化のAIエージェント「ミセルAI」を開発・運営しています。
目次
- AIクローラーとは?——3つの種類
- 主要なAIクローラー一覧(2026年11月時点)
- 拒否(ブロック)すべきか?判断の基準
- robots.txtの書き方(そのまま使える例)
- robots.txtが効かないケースと対策
- 法的な位置づけ——文化庁の考え方
- これからの動き——AI学習の共通ルール
- 当サイトの設定と、その理由
- よくある質問
AIクローラーとは?——3つの種類
AIクローラーとは、AIを提供する企業が運営する、ウェブページを自動で集めるボットのことです。Googleの検索のためのGooglebotと同じしくみですが、集めた情報の使い道が違います。各社の公式な説明を見ると、AIクローラーは大きく次の3種類に分かれます。
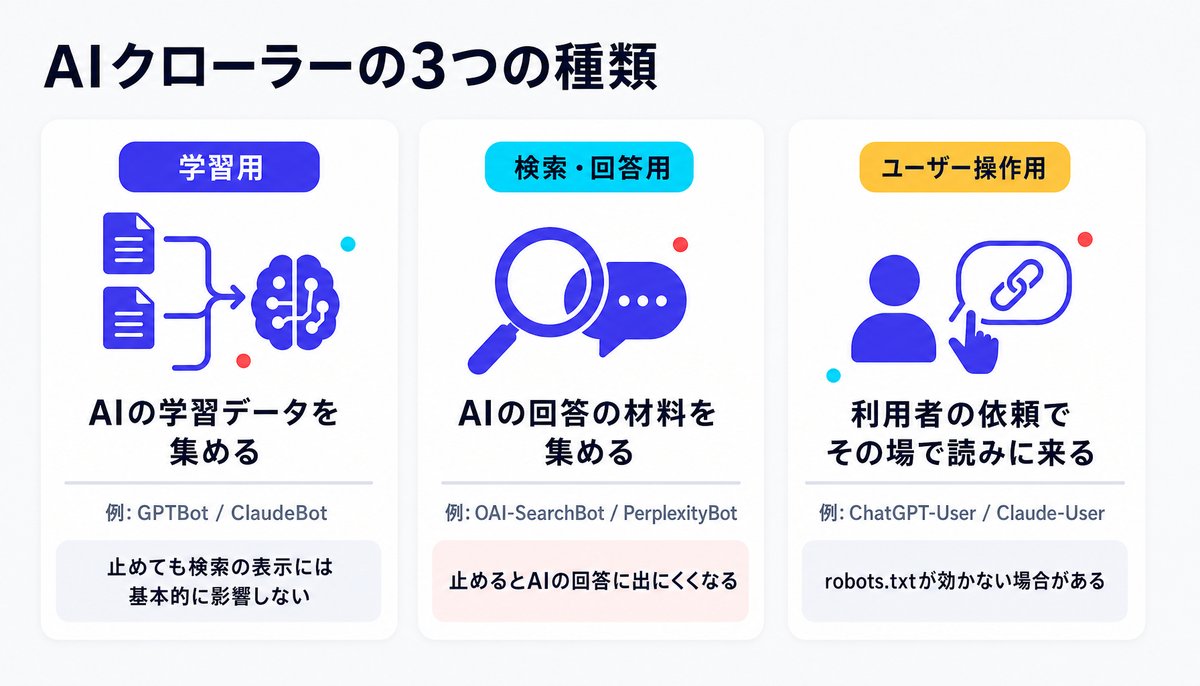
- 学習用: AIのモデルを学習させるためのデータを集める。止めると、今後の学習に使われなくなる
- 検索・回答用: AIの検索機能や回答の材料にするためにページを集める。止めると、そのAIの回答で紹介されにくくなる
- ユーザー操作用: 利用者が「このページを読んで」と頼んだときなどに、その場でページを取りに来る。利用者の依頼によるため、robots.txtが適用されない場合があると各社が説明している
ここ1〜2年でAIクローラーが話題になっている背景には、量の急増があります。CDN大手のCloudflareは、同社のネットワークで観測したクローラーのリクエストのうち、AIの学習を目的とするものが2026年6月時点で52%に達し、2025年春の22%から増えたと報告しています。
主要なAIクローラー一覧(2026年11月時点)
主要な企業のボットを、公式の説明にもとづいて整理しました。「robots.txtに書く名前」は、robots.txtの「User-agent:」に指定する名前です。
| 企業 | robots.txtに書く名前 | 種類 | 止めると起きること(公式の説明) |
|---|---|---|---|
| OpenAI(ChatGPT) | GPTBot | 学習用 | 基盤モデルの学習に使われなくなる。各設定は独立していて、検索用とは別に止められる |
| OAI-SearchBot | 検索・回答用 | ChatGPTの検索の回答に表示されなくなる(ナビゲーション用のリンクとしては出ることがある) | |
| ChatGPT-User | ユーザー操作用 | 検索に出るかどうかの判断には使われない。利用者の操作によるため、robots.txtが適用されない場合がある | |
| Anthropic(Claude) | ClaudeBot | 学習用 | 今後の学習データから外す意思表示になる |
| Claude-SearchBot | 検索・回答用 | 検索結果での表示や正確さが下がる可能性がある | |
| Claude-User | ユーザー操作用 | 利用者の依頼による検索での表示が減る可能性がある | |
| Perplexity | PerplexityBot | 検索・回答用 | 検索結果に出るには許可を推奨。基盤モデルの学習には使わないと説明 |
| Perplexity-User | ユーザー操作用 | 利用者の依頼による取得のため、一般にrobots.txtを無視する | |
| Google(Gemini) | Googlebot | 検索用(AIによる概要・AIモードを含む) | Google検索に表示されなくなる。AI対策のために止めてはいけない |
| Google-Extended | 学習用(個別のクローラーはない) | Geminiの学習に加え、Geminiアプリでの回答の根拠づけにも使われなくなる。Google検索への掲載や順位には影響しない | |
| Google-GeminiNotebook など | ユーザー操作用 | 利用者の依頼による取得のため、一般にrobots.txtを無視する | |
| Apple(Siri・Spotlight) | Applebot | 検索用(学習にも使われうる) | Siri・Spotlight・Safariの検索機能に出なくなる |
| Applebot-Extended | 学習用(クロールはしない) | Appleの生成AIの基盤モデルの学習から外れる。止めても検索結果には含まれうる | |
| Meta(Meta AI) | Meta-ExternalAgent | 学習用 | AIの基盤モデルの学習や、製品の改善のための収集から外れる |
| Meta-WebIndexer | 検索・回答用 | Meta AIの検索結果の品質向上のための収集から外れる | |
| Meta-ExternalFetcher | ユーザー操作用 | 利用者の依頼による取得のため、robots.txtを迂回することがある | |
| Amazon(Alexaなど) | Amazonbot | 学習用(製品の改善にも使う) | 製品・サービスの改善や、AmazonのAIモデルの学習に使われなくなる |
| Amzn-SearchBot | 検索・回答用 | Amazonの製品の検索体験のための収集から外れる。生成AIの学習には使わないと説明 | |
| Amzn-User | ユーザー操作用 | Alexaの質問への回答などのための取得。robots.txtのすべてには従わない場合がある | |
| Microsoft(Copilot) | Bingbot | 検索用 | Bingの検索に出なくなる。CopilotやBingのAI要約での引用状況は、Bing Webmaster Toolsの「AI Performance」で確認できる |
| DuckDuckGo | DuckAssistBot | 回答用 | AIによる回答の情報源にならなくなる(反映は72時間後)。学習には使わず、通常の検索順位にも影響しない |
| Common Crawl | CCBot | 公開データセット用 | 誰でも使える公開のウェブデータに含まれなくなる。データの使い道は利用者しだいで、AIの開発に使われることもある |
| ByteDance(TikTok) | Bytespider | — | ByteDanceのクローラーとして知られるが、運営元による公式の説明ページは確認できなかった |
※2026年11月3日時点で各社の公式ページを確認した内容です。ボットの名前や役割は追加・変更されることがあります(Amazonは、学習にも使われるAmazonbotとは別に、検索用のAmzn-SearchBotとユーザー操作用のAmzn-Userを公開しています。Googleは、ユーザー操作用の旧名Google-NotebookLMの扱いを2026年8月までとし、Google-GeminiNotebookに切り替えています)。
表の中で特に気をつけたいのが、Google-Extendedです。名前に「Google」とあるので検索に関係しそうですが、Google検索(AIによる概要・AIモードを含む)への掲載や順位には影響しません。その一方で、Geminiの学習だけでなく、Geminiアプリで回答の根拠として使うかどうかもこの設定で決まります。学習だけを断る、という使い分けができない点が、ほかの会社と違います。
拒否(ブロック)すべきか?判断の基準
結論から言うと、店舗や中小企業のサイトの多くは、何も止めなくて構いません。止めるとしても、学習用だけにするのが基本です。判断の流れは次のとおりです。
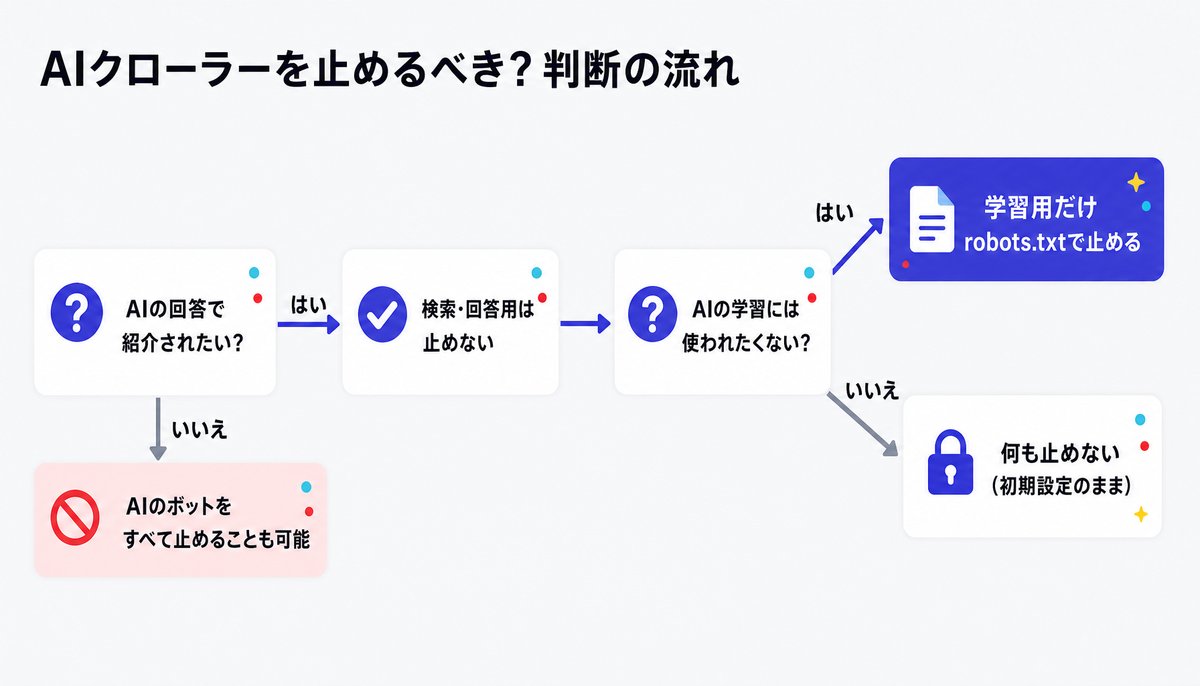
止めないほうがいいもの: 検索・回答用
お店や会社を、ChatGPTやPerplexityなどのAIの回答で紹介してほしいなら、OAI-SearchBot・Claude-SearchBot・PerplexityBotなどの検索・回答用は止めないでください。AIの回答に出るための考え方は「GEO対策とは?」で解説しています。もちろん、Googlebotを止めると、Google検索そのものから消えてしまいます。
方針しだいで止めるもの: 学習用
学習用を止めても、各社の説明では、検索での表示には基本的に影響しません。止めるかどうかは方針しだいです。次のようなサイトは、学習用を止める理由があります。
- 記事やデータそのものが商品のサイト: 有料の記事、データベース、専門的な資料など。AIの学習用データとして販売・提供する予定があるなら、止めておくことに意味があります(後述)
- 作品を公開しているサイト: イラスト・写真・文章などの作品を、AIの学習に使われたくない場合
- サーバーへの負荷が問題になっているサイト: ログで特定のボットのアクセスが目立つ場合
一方、お店の情報や、サービスの紹介をしているサイトなら、止める理由はあまりありません。止めない場合に気にすべきなのは、主に「今後のAIの学習に使われるかもしれない」ことと、サーバーへの負荷です。AIの回答での紹介のされ方には、学習用より検索・回答用のほうが直接関わります。
robots.txtの書き方(そのまま使える例)
AIクローラーを止める基本の方法は、サイトの直下にある「robots.txt」というファイルに、止めたいボットの名前と範囲を書くことです。まずはブラウザで「https://(自分のドメイン)/robots.txt」を開き、いまの中身を確かめてください。
例1: 学習用のボットだけを止める(おすすめ)
# AIの学習用ボットだけを止める例(検索・回答用は止めない)
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: Amazonbot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Bytespider
Disallow: /
Geminiの学習も断りたい場合は、「User-agent: Google-Extended」「Disallow: /」を追加します。ただし前述のとおり、Geminiアプリで回答の根拠として使われることもなくなるので、AIに紹介されたいサイトは慎重に判断してください。
例2: 一部のフォルダだけを止める
# 作品や資料のフォルダだけを、学習用ボットから外す例
User-agent: GPTBot
Disallow: /works/
Disallow: /download/

User-agent: ClaudeBot
Disallow: /works/
Disallow: /download/
例3: AIのボットをすべて止める(AIに紹介されなくてよい場合)
学習用に加えて、次の検索・回答用やユーザー操作用も止めます。AIの回答で紹介されなくなることを理解したうえで使ってください。Googlebotは止めないでください。
# 例1の内容に加えて、検索・回答用とユーザー操作用も止める
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: DuckAssistBot
Disallow: /
※robots.txtでは、このように複数の「User-agent:」を並べて、同じ指定をまとめて書くこともできます。
書くときの注意点
- 反映には時間がかかる: OpenAI(検索)・Perplexity・Amazonは約24時間、DuckDuckGoは72時間かかると説明しています
- 名前を指定したボットは、「User-agent: *」の指定を見なくなる: ボットは自分の名前のグループだけに従うため、「*」に書いた制限(管理画面の除外など)は、個別のグループには引き継がれません
- WordPressの場合: WordPressは、サーバーにrobots.txtのファイルがなければ、自動で作ったrobots.txtを出します。All in One SEOなどのSEOプラグインには、この内容を管理画面から編集する機能があります。サーバーにrobots.txtのファイルを置いた場合は、そちらが表示されます
- 書き間違いの確認: Google Search Consoleの「robots.txt」レポート([設定]の中)で、Googleが読み取った内容とエラーを確認できます
robots.txtが効かないケースと対策
robots.txtは、ボットに守ってもらう「お願い」で、アクセスそのものを止める仕組みではありません。主要な企業は守ると表明していますが、次のような場合は効かないことがあります。
- ユーザー操作用のボット: ChatGPT-User、Perplexity-User、Meta-ExternalFetcher、Amzn-User、GoogleのGemini Notebookなどは、利用者の依頼によるため、robots.txtが適用されない場合があると各社が説明しています
- 名前を偽るボット: Common Crawlは、CCBotを名乗る偽のクローラーがいると注意を呼びかけています。また、Cloudflareは2025年に、大手のAI企業が、robots.txtで拒否されたサイトに、名乗らないクローラーでアクセスしていたと公表しました
- ルールを守らないボット: 運営元がはっきりしないボットは、robots.txtを読まないこともあります
確実に止めたい場合は、次の方法を組み合わせます。
- サーバーやCDNで止める: CloudflareのAI Crawl Control(旧AI Audit)のように、どのAIのボットが来ているかを見て、ボットごとに許可・ブロックできるサービスもあります。各社が公開しているIPアドレスの一覧と照らして、本物かどうかを確かめる方法もあります
- ログインが必要な場所に置く: 文化庁も、学習に使われたくない作品は、IDとパスワードでのログインが必要な領域に置くことが、収集を防ぐうえで役立つとしています
AIクローラーが来ているか確かめる方法
実際にどのボットが来ているかは、サーバーのアクセスログで確認できます。レンタルサーバーの管理画面などからログを取り出し、「GPTBot」「ClaudeBot」「Amazonbot」などの名前で検索してください。CDNを使っている場合は、その管理画面でボットのアクセスを確認できることもあります。
法的な位置づけ——文化庁の考え方
「robots.txtで止めておけば、AIの学習は法律で禁止されるのか」という疑問には、文化庁の資料が参考になります。文化審議会の小委員会が2024年3月にまとめた「AIと著作権に関する考え方について」では、次のように整理されています(25〜26ページ)。
- robots.txtでAI学習用のクローラーのアクセスを制限するような、機械が読み取れる技術的な措置をとることは、著作権法上の特段の制限はなく、サイトの管理者の判断で自由に行える
- 一方で、著作権者が反対の意思を示していることそれ自体で、AIの学習を認める規定(著作権法30条の4)の対象から外れるとは考えられない
- 技術的な措置がとられていて、さらに、そのサイトのデータを含むデータベースを将来販売する予定があると推認される場合などには、措置を回避して学習のために集める行為が、30条の4の例外(ただし書)に当たりうる
また、文化庁の「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月)では、権利者向けに、robots.txtにAI学習用のクローラーを止める記載をすることで、収集を「一定程度防ぐことができる」と説明しています(ボットの側がrobots.txtに従う設定であることが前提)。
つまりrobots.txtは、学習を法的に禁止する道具ではなく、意思を示し、収集を減らすための技術的な手段という位置づけです。具体的な権利の問題は、専門家に相談してください。
これからの動き——AI学習の共通ルール
いまは、会社ごとにボットの名前を調べて、1つずつ書く必要があります。文化庁の資料も、robots.txtでは「AI学習用のクローラーだけをまとめて止める」ことができないという技術的な限界を指摘しています。
この状況を変える動きが進んでいます。インターネットの標準を話し合うIETFでは、「AIの学習に使ってよいか」などの利用の希望を、robots.txtやHTTPのヘッダーで伝える共通の書き方(AIPREF)が議論されています。2026年11月時点では草案の段階で、正式な標準にはなっていません。
そしてGoogleは、2026年10月30日に、このAIPREFの議論にもとづくAI学習の共通の指定を、2027年にほかのAI企業とともにサポートする計画を発表しました。共通の指定で学習を断り、Google-Extendedを個別に書いていない場合は、Google-Extendedを拒否したものとして扱う予定です。既存のGoogle-Extendedの設定は、引き続き使えます。正式な書き方が決まるまでは、この記事の例のように、会社ごとの名前で指定しておくのが確実です。
当サイトの設定と、その理由
当サイト(ミセルAI公式サイト)のrobots.txtは、2026年11月時点で、管理画面を除いてすべてのボットを許可しています。AIのボットを個別に止める設定はしていません。
理由はシンプルで、当サイトの記事は、AIの回答を含めて、できるだけ多くの人に見つけてもらうために書いているからです。記事そのものを商品として販売しているわけでもないので、学習用を止める理由もありません。実際、当サイトのGoogleアナリティクスでは、ChatGPTやGeminiのサービスから訪れた人がわずかながら記録されています(GEO対策の記事で実測値を紹介しています)。
あわせて知っておきたいのが、llms.txtはAIクローラーを止めるためのファイルではないということです。llms.txtは「読んでほしいページの案内」で、拒否の機能はありません。詳しくは「llms.txtとは?」をご覧ください。
よくある質問
Q. AIクローラーとは何ですか?
ChatGPTやClaude、Geminiなどを提供する企業が、AIの学習や、AIの検索・回答の材料にするためにウェブページを集めるボットのことです。学習用・検索/回答用・ユーザー操作用の3種類に分かれ、各社は用途ごとに別の名前のボットを使っています。
Q. AIクローラーを拒否すると、SEOに影響しますか?
学習用のボット(GPTBot、ClaudeBot、Google-Extendedなど)を止めても、Google検索の順位には影響しません。Googleは、Google-ExtendedがGoogle検索への掲載や順位に影響しないと説明しています。ただし、Googlebotを止めるとGoogle検索に表示されなくなります。
Q. GPTBotとOAI-SearchBotの違いは何ですか?
GPTBotはOpenAIのAIの学習用、OAI-SearchBotはChatGPTの検索用のボットです。設定は独立していて、GPTBotだけを止めれば、学習は断りつつ、ChatGPTの検索の回答には表示される状態にできます。OAI-SearchBotを止めると、ChatGPTの検索の回答に表示されなくなります。
Q. Google-Extendedを止めると、AIによる概要に出なくなりますか?
出なくなることはありません。Google-Extendedは、Google検索(AIによる概要・AIモードを含む)への掲載や順位には影響しません。ただし、Geminiの学習に加えて、Geminiアプリで回答の根拠として使われることもなくなります。
Q. robots.txtで止めれば、AIの学習を法的に禁止できますか?
robots.txtだけで法的に禁止できるわけではありません。文化庁の「AIと著作権に関する考え方について」は、robots.txtでAI学習用のクローラーを制限することはサイト管理者が自由に行えるとする一方、反対の意思表示があるだけでは、AIの学習を認める規定の例外に当たるとは考えられないと整理しています。
Q. 「ClaudeBot」と「Clawdbot」は同じものですか?
別のものです。ClaudeBotは、Claudeを提供するAnthropicの学習用クローラーです。Clawdbotは、個人の開発者が公開したAIアシスタントのソフトで、名前がClaudeに似ているとして、2026年1月にMoltbotへ改名したと報じられています。
Q. llms.txtでAIクローラーを拒否できますか?
できません。llms.txtは、AIに読んでほしいページを案内するためのファイルで、拒否の機能はありません。AIクローラーを止めるときは、robots.txtを使います。
Q. AIクローラーでサーバーが重くなるときは、どうすればいいですか?
まずアクセスログで、どのボットが多いかを確かめます。原因のボットをrobots.txtで止めるか、巡回の間隔を指定する「Crawl-delay」を使います。Crawl-delayはCommon CrawlやAnthropicのように対応している会社と、Amazonのように対応していない会社があります。急ぎの場合は、サーバーやCDNの機能でアクセスそのものを止めます。
まとめ: 止めるなら「学習用だけ」が基本
AIクローラーは、学習用・検索/回答用・ユーザー操作用の3種類に分かれています。AIの回答で紹介されたいなら、検索・回答用は止めないこと。学習に使われたくない場合も、止めるのは学習用だけにするのが基本です。Google-Extendedだけは、Geminiアプリでの回答の根拠づけも一緒に止まる点に注意してください。
まずは今日、自分のサイトのrobots.txtを開いて、意図しないボットを止めていないかを確かめてください。過去に「AI対策」として一括で止めた設定が、いまのAI検索の時代には逆効果になっていることもあります。
「設定はわかったが、AIに選ばれる記事を作り続ける時間がない」という場合は、そこを自動化する選択肢もあります。ミセルAIは、SEO・MEO・AEO/LLMOの発信を自動化する集客AIエージェントで、自社ノウハウ設定機能により、あなたの会社やお店ならではのエピソードを記事に反映できます。無料相談(オンライン30分・勧誘なし)で、何から始めるべきかをお答えします。
※この記事の内容は、2026年11月3日時点の各社の公式情報と、文化庁の資料で確認しています。ボットの名前や役割は変わることがあるため、設定の前に各社の最新の説明をご確認ください。法的な判断が必要な場合は、専門家にご相談ください。
参考: Overview of OpenAI Crawlers/Anthropic のクローラーについて(Claude ヘルプセンター)/Perplexity Crawlers/Google の一般的なクローラー/Google のユーザー トリガー フェッチャー/Google 検索セントラル ブログ(2026年10月30日)/About Applebot/Meta Web Crawlers/Amazonbot/CCBot(Common Crawl)/DuckAssistBot/AI Crawl Control(Cloudflare)/Content Independence Day, one year on(Cloudflare)/IETF AI Preferences(aipref)/AIと著作権について(文化庁)
この記事を書いた人: 宮川椋(合同会社LeapRe 代表)。集客特化のAIエージェント「ミセルAI」を開発・運営。SEO・MEO・AEO/LLMOの自動化を通じて、広告に頼らない資産型の集客づくりを支援しています。他の記事はコラム一覧から。